
昨天把呈現與回應這條線收尾了。今天正式轉進 AI 主線,想先劃清界線,再往下講細節——這篇算是接下來八天的地基。
AI 該做的事
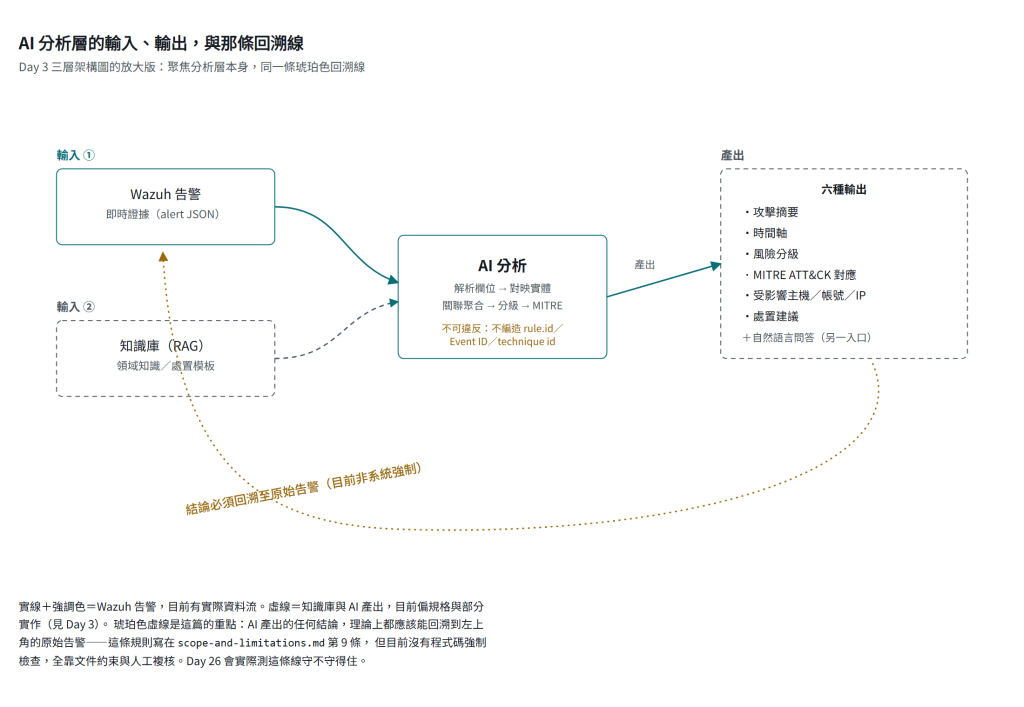
設計上,AI 接兩種輸入:Wazuh 的即時告警,跟這個專案自己整理的知識庫(透過 RAG 檢索)。 拿這兩者去產出:攻擊摘要、時間軸、風險分級、MITRE ATT&CK 對應、受影響主機/帳號/來源 IP 的整理、處置建議,以及回答自然語言問題。
簡單說:告警負責回答「現在發生了什麼」,知識庫負責回答「這代表什麼、該怎麼處置」,AI 的工作是把兩者串成一個人看得懂的敘事。
不能做的事
我在專題一開始就寫了一份範圍與限制文件,列了九條邊界。 今天想聚焦在其中一條,因為它是整個 AI 分析層最核心的一條規矩:
AI/ML 不作證據來源。LLM 摘要與模型分類必須回溯至原始事件;缺資料或缺指標時標為未驗證。
白話講就是:AI 講出來的話,不能自己就是證據。 它必須能指回某一筆具體的告警、某一個具體的欄位——如果沒有,那句話就只是一個看起來很專業的猜測,不是分析結果。
這條規矩,我在 Day 3 就已經畫出來了
回頭看 Day 3 那張三層架構圖,裡面有一條刻意畫出來的琥珀色虛線:分析層的產出理論上應該要能回溯到原始的 Alert JSON,但這條回溯目前不是系統強制的。當時我是從架構設計的角度直覺畫出這條線,還沒有去對照這份範圍文件裡寫死的規矩——現在寫到這裡,對照起來,兩者講的其實是同一件事。 這算是一個小小的驗證:當時的直覺跟後來寫下來的規矩,方向是一致的。
這件事讓我覺得,「防幻覺」不是一個只套用在 AI 身上的規則,是一種寫作跟分析共通的紀律:誰在下結論,誰就要能指出證據在哪裡,不管下結論的是人還是模型。
Day 3 已經提過一次,這裡再講清楚:「分析產出要回溯原始告警」這件事,目前不是系統技術上強制的,是寫在規格文件裡的一條規則,沒有程式碼去檢查「AI 這次的回答有沒有真的連到一個存在的 rule.id」。 也就是說,如果 AI 真的編了一個不存在的規則編號,目前沒有東西會自動擋下來,全靠這份文件裡的文字約束跟人工複核...
這個落差——規則寫下來了,但沒有被強制執行——正是 Day 26 我想真的動手測的東西:找一筆資訊不足的真實告警,看看在這份規則的約束下,AI 實際上守不守得住,還是會在資料不夠的時候忍不住編一個聽起來合理的答案。
明天
接下來想講告警裡那些欄位,實際上是怎麼被餵給 AI 的。
感謝你看到這邊,明天見~


 iThome鐵人賽
 看影片追技術